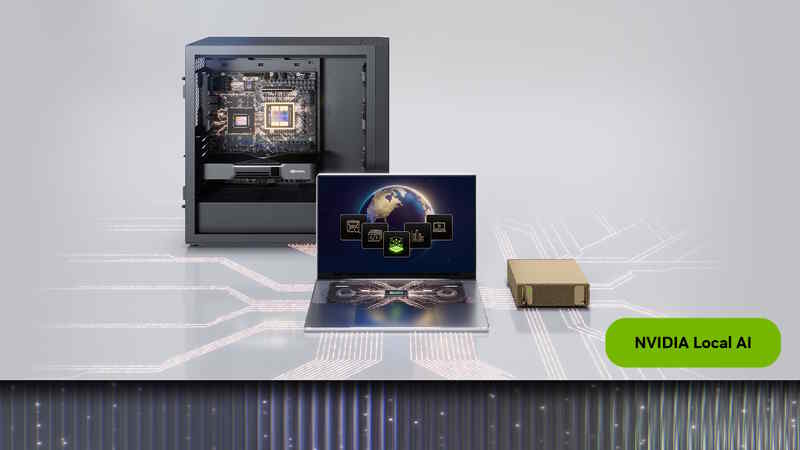
L’intelligenza artificiale si prepara a diventare sempre più indipendente dal cloud. In occasione della GTC di Berlino, NVIDIA ha annunciato una serie di novità dedicate all’AI locale, puntando su computer capaci di eseguire modelli avanzati direttamente sui propri sistemi, con applicazioni che spaziano dalla programmazione alla creazione di contenuti, dalla robotica all’automazione industriale. Al centro della strategia ci sono RTX Spark, DGX Spark e DGX Station, affiancati da nuovi modelli AI, strumenti per sviluppatori e soluzioni pensate per rendere più semplice la gestione degli agenti intelligenti.
RTX Spark: scopri i prodotti NVIDIA e le migliori soluzioni per l’AI
Computer, schede grafiche e accessori per chi vuole sfruttare la potenza dell’hardware NVIDIA, dalla creazione di contenuti al mondo dell’intelligenza artificiale.
SCOPRI I PRODOTTI NVIDIA SU AMAZON
Acquistando tramite il link potresti contribuire a sostenere ItaliaTopGames, senza costi aggiuntivi per te.
NVIDIA punta sull’intelligenza artificiale eseguita in locale
La direzione indicata da NVIDIA è chiara: rendere possibile l’esecuzione di modelli AI sempre più sofisticati sulle macchine degli utenti e delle aziende. L’elaborazione locale può offrire vantaggi importanti in termini di controllo dei dati, autonomia operativa e flessibilità, riducendo la necessità di inviare ogni richiesta a servizi remoti. Naturalmente, prestazioni e modelli utilizzabili dipendono dalla memoria disponibile, dall’hardware e dal tipo di attività da svolgere.
Le tre piattaforme presentate da NVIDIA rispondono a esigenze differenti. RTX Spark è orientata all’utilizzo personale e ai PC Windows, DGX Spark si rivolge soprattutto a sviluppatori e appassionati che lavorano con Linux, mentre DGX Station punta a team professionali e aziende che hanno bisogno di capacità di calcolo molto superiori.
RTX Spark porta gli agenti AI sui PC Windows
RTX Spark è stata lanciata il 16 ottobre e rappresenta una delle novità centrali della strategia NVIDIA per l’intelligenza artificiale locale. La piattaforma promette fino a 128 GB di memoria unificata e un picco dichiarato di un petaflop di calcolo AI, con l’obiettivo di affiancare alle attività tradizionali del PC anche l’esecuzione di agenti intelligenti e applicazioni creative accelerate.
Tra le novità annunciate a Berlino c’è Underdog Desktop Agent, un’applicazione progettata per eseguire agenti AI interamente sul dispositivo. Il sistema utilizza il motore di inferenza Husky e punta a consentire l’elaborazione locale delle richieste, evitando che i dati personali debbano necessariamente lasciare il computer per essere gestiti da un servizio cloud.
Questo approccio può risultare particolarmente interessante per chi lavora con documenti, codice e contenuti riservati. L’elaborazione locale, tuttavia, non garantisce automaticamente la privacy in ogni situazione: contano anche le impostazioni del software, le eventuali connessioni esterne e i servizi integrati nell’applicazione.
NVIDIA ha inoltre mostrato come gli agenti AI possano essere utilizzati per addestrare il robot Microduck di Hugging Face attraverso strumenti come Isaac Lab, Hermes Agent e Nemotron. Un esempio che evidenzia come le applicazioni dell’intelligenza artificiale locale possano andare ben oltre la semplice conversazione con un chatbot.
DGX Spark: più memoria e cluster fino a otto sistemi
Per sviluppatori e professionisti che hanno bisogno di una piattaforma dedicata, NVIDIA ha confermato l’arrivo delle configurazioni DGX Spark con 64 GB di memoria unificata, previste presso i partner a partire dal 23 ottobre. La nuova versione amplia le possibilità di accesso alla piattaforma, mantenendo il chip GB10 Grace Blackwell, il sistema operativo DGX OS e lo stack software AI di NVIDIA.
La novità più significativa riguarda però la possibilità di collegare più sistemi. Grazie alla rete NVIDIA ConnectX-7 e agli strumenti di configurazione NVIDIA Sync, gli sviluppatori possono costruire configurazioni distribuite per affrontare carichi di lavoro che richiedono più memoria, contesti più lunghi o più agenti contemporaneamente.
NVIDIA Sync supporta cluster fino a otto unità DGX Spark in configurazione manuale, per un totale dichiarato di 1 TB di memoria unificata. Una possibilità che può interessare piccoli team di sviluppo intenzionati a condividere un’infrastruttura AI locale, anziché affidare ogni elaborazione a risorse cloud.
Nel corso del mese è inoltre previsto l’arrivo di NVIDIA Sync Model Launcher. L’obiettivo è semplificare il download e l’avvio dei modelli compatibili, predisponendo anche l’ambiente necessario per lavorare con OpenCode. L’aggiornamento software di ottobre introduce poi un Wi-Fi Assistant e migliora gli strumenti di assistenza per la manutenzione e la risoluzione dei problemi.
DGX Station guarda alle aziende e ai carichi di lavoro più impegnativi
All’estremo superiore dell’offerta troviamo DGX Station, una soluzione pensata per team che devono gestire modelli AI avanzati e numerose richieste contemporanee. NVIDIA dichiara fino a 748 GB di memoria coerente e prestazioni di calcolo AI fino a 20 petaflop, con la possibilità di servire oltre 30 utenti in determinati scenari di utilizzo.
La piattaforma amplia anche le possibilità di gestione aziendale grazie a sette nuove integrazioni con strumenti di sicurezza, amministrazione e gestione dei dispositivi, tra cui Microsoft Intune, Splunk e Tanium. L’obiettivo è rendere più semplice inserire questi sistemi nei processi informatici già utilizzati dalle organizzazioni.
Un’altra novità riguarda DGX Station per Windows, attesa a dicembre attraverso i produttori partner. La versione Windows è progettata per avvicinare l’AI locale alle applicazioni professionali utilizzate quotidianamente in ambiti come progettazione, simulazione, validazione e ingegneria. Tra i software e gli ambienti citati da NVIDIA figurano soluzioni di Dassault Systèmes, Siemens, MathWorks, Unity e altri operatori del settore.
Per la robotica, NVIDIA ha inoltre presentato tre flussi di lavoro open source che combinano strumenti come Isaac Lab, Isaac Lab-Arena e Cosmos. Queste risorse sono pensate per attività quali l’addestramento di abilità di manipolazione, il perfezionamento dei modelli robotici e la generazione di dati sintetici.
Recursive Flint: un nuovo modello AI specializzato nella programmazione
Tra gli annunci più interessanti c’è Recursive Flint, un modello linguistico sviluppato da Recursive Superintelligence e ottimizzato per la generazione di codice. Si tratta di un modello mixture-of-experts da 40 miliardi di parametri complessivi, con 2,5 miliardi di parametri attivi per token.
Secondo i dati diffusi dai suoi sviluppatori, Recursive Flint può superare i 220 token al secondo su RTX Spark da 64 GB. L’azienda sostiene inoltre di aver ottenuto un incremento del 55% nella velocità di generazione grazie a kernel specializzati, senza modificare i pesi del modello.
Il modello viene distribuito con pesi aperti attraverso Hugging Face e licenza Apache 2.0. Può essere eseguito su RTX Spark e DGX Spark, ma anche su GPU NVIDIA GeForce RTX e RTX PRO compatibili. La disponibilità di pesi aperti offre agli sviluppatori maggiore libertà di sperimentazione e personalizzazione, fermo restando che prestazioni e requisiti variano in base alla configurazione hardware.
Nuovi modelli AI e supporto fin dal giorno del lancio
NVIDIA ha annunciato anche il supporto iniziale per una nuova serie di modelli, tra cui Nemotron Bolt E4B, GLM, DeepSeek, Qwen, MiniMax, Liquid AI LFM2.5-24B-A2B e FLUX.3 Klein. L’obiettivo è ampliare le possibilità di utilizzo dell’hardware locale per ragionamento, generazione di immagini, assistenti vocali e agenti capaci di interagire con strumenti esterni.
Nemotron Bolt E4B è progettato per funzionare con requisiti di memoria contenuti, a partire da circa 4 GB nelle configurazioni indicate da NVIDIA. Può quindi trovare spazio in assistenti vocali locali, interfacce interattive e personaggi virtuali, oltre che sui sistemi RTX e DGX compatibili. Il rilascio è previsto per il 23 ottobre.
Per la generazione e la modifica delle immagini arriva invece FLUX.3 Klein, un modello open-weight da 5,6 miliardi di parametri sviluppato da Black Forest Labs. NVIDIA dichiara che le versioni ottimizzate possono funzionare su GPU GeForce RTX con almeno 8 GB di memoria video e generare un’immagine da un megapixel in circa quattro secondi su RTX 5090.
Tra le altre novità figura LFM2.5-24B-A2B di Liquid AI, un modello di ragionamento che attiva due miliardi di parametri per token su un totale di 24 miliardi. NVIDIA ha inoltre annunciato checkpoint ottimizzati per contenere l’utilizzo della RAM, con l’obiettivo di lasciare più memoria disponibile per la gestione del contesto durante l’inferenza.
llama.cpp e vLLM: miglioramenti anche per la velocità dell’AI
La strategia non si limita ai nuovi modelli e all’hardware. NVIDIA continua a collaborare con le comunità open source che sviluppano llama.cpp e vLLM, due strumenti importanti per eseguire modelli linguistici e gestire carichi di inferenza.
Tra le ottimizzazioni annunciate ci sono miglioramenti alla decodifica speculativa e ai kernel di elaborazione del contesto. NVIDIA riporta incrementi fino a 1,4 volte nella velocità di alcune attività agentiche su RTX PRO 6000 Blackwell con llama.cpp e fino a 1,3 volte su DGX Spark con vLLM in specifici scenari di utilizzo.
Si tratta di risultati dichiarati per configurazioni e modelli determinati, non di un incremento garantito per qualsiasi applicazione AI. Il dato importante è che il lavoro sull’efficienza del software può rendere più sfruttabile l’hardware già disponibile, soprattutto quando si eseguono modelli localmente e si vogliono mantenere attivi più processi.
AI locale: perché queste novità sono importanti
Gli annunci della GTC di Berlino mostrano un settore che sta evolvendo rapidamente. NVIDIA sta costruendo un ecosistema nel quale computer personali, workstation e sistemi dedicati possono eseguire modelli AI, ospitare agenti autonomi e sostenere flussi di lavoro sempre più complessi senza dipendere necessariamente da un’infrastruttura cloud per ogni singola operazione.
RTX Spark punta a rendere queste possibilità più accessibili sul fronte dei PC personali, DGX Spark offre una base dedicata agli sviluppatori e alle configurazioni scalabili, mentre DGX Station si rivolge alle aziende che necessitano di maggiore capacità di calcolo e gestione centralizzata.
Restano da valutare aspetti concreti come prezzi, consumi, compatibilità dei software, disponibilità dei modelli e prestazioni nelle applicazioni quotidiane. Non tutti gli utenti hanno bisogno di una macchina specializzata per l’AI, e per molte attività i servizi cloud continueranno a rappresentare una soluzione pratica. Per chi lavora con modelli locali, dati riservati o agenti che devono operare con continuità, però, la direzione intrapresa da NVIDIA potrebbe aprire scenari sempre più interessanti.
La partita dell’intelligenza artificiale, insomma, non si gioca soltanto nei grandi data center. Una parte sempre più importante del futuro dell’AI passerà anche dai computer sulle scrivanie degli utenti, dagli strumenti open source e dalla possibilità di decidere dove e come eseguire i propri modelli.
“`
Trasparenza editoriale: Questo contenuto potrebbe includere link affiliati dai quali ItaliaTopGames potrebbe ricevere una commissione. Per conoscere i dettagli della nostra policy editoriale, Leggi l'informativa completa sulla trasparenza